
Если вы внедряете системы видеоаналитики, корпоративные ИИ-сервисы, локальные большие языковые модели (LLM) или строите инфраструктуру для распределённого инференса и понимаете, что облачные ресурсы подходят не для всех задач, эта статья для вас. В ней мы разберём, как серверы для искусственного интеллекта (ИИ) компании Firefly помогают решать такие задачи на практике: какие серверные платформы существуют; для каких сценариев они подходят; почему Firefly становится интересной альтернативой традиционным серверам на основе графических ускорителей (GPU) и дорогостоящей ИИ-инфраструктуре в реальных коммерческих проектах.
В последние годы искусственный интеллект развивается не только в облачных дата-центрах, но всё чаще перемещается в локальную серверную инфраструктуру компаний – ближе к данным, бизнес-процессам и точкам принятия решений. Распределённые ИИ-серверы, кластеры периферийных вычислений (edge computing – периферийные вычисления) и компактные серверные платформы позволяют запускать инференс (логический вывод) нейросетей, частные ИИ-ассистенты и даже большие модели непосредственно в собственной инфраструктуре – без зависимости от публичного облака.
Дополнительный импульс этому направлению дал рост интереса к частному развёртыванию моделей внутри организаций. Всё больше компаний рассматривают локальные LLM, то есть большие языковые модели, и генеративные модели не как эксперимент, а как рабочий инструмент для автоматизации процессов, обработки документов, аналитики и корпоративных помощников. Однако для таких задач уже недостаточно отдельных ускорителей или универсальных серверов: требуется специализированная инфраструктура для ИИ-нагрузок, способная масштабироваться и эффективно работать в круглосуточном режиме.
На мировом рынке серверных решений для ИИ традиционно доминируют крупные поставщики GPU-инфраструктуры, прежде всего решения на базе NVIDIA. Однако такие платформы зачастую требуют значительных инвестиций, сложной инженерной интеграции и нередко оказываются избыточными для задач инференса или распределённых ИИ-сервисов. Именно поэтому растёт интерес к альтернативным архитектурам – модульным, масштабируемым и ориентированным именно на ИИ-нагрузки, а не только на классические серверные вычисления.
На этом фоне особый интерес представляет компания Firefly Technology Co., Ltd. (далее – Firefly), известная не только своими встраиваемыми платформами для периферийного ИИ, но и линейкой серверов для распределённых ИИ-вычислений и кластерного инференса. Firefly предлагает решения разного класса: от компактных многоузловых ИИ-серверов до полноценных кластерных платформ и микро-датацентров для развёртывания больших моделей.
Их объединяет общая идея:
- высокая плотность вычислений; энергоэффективность; модульность;
- возможность масштабирования без перехода к дорогостоящей традиционной GPU-инфраструктуре.
Именно поэтому серверы Firefly всё чаще рассматриваются не просто как нишевые решения для периферийных вычислений, а как полноценная платформа для построения современной частной ИИ-инфраструктуры – от локального инференса и видеоаналитики до серверов для LLM и распределённых ИИ-кластеров. Далее рассмотрим, какие классы таких систем предлагает Firefly и для каких задач они подходят.
Компактные серверы для инференса и частных развёртываний ИИ
Для задач, где требуется локальный инференс нейросетей, обработка видеопотоков в реальном времени или приватное развёртывание ИИ-моделей без перехода к полноценной серверной инфраструктуре дата-центра, Firefly предлагает компактные многоузловые ИИ-серверы начального уровня, такие как CSA1-N8.
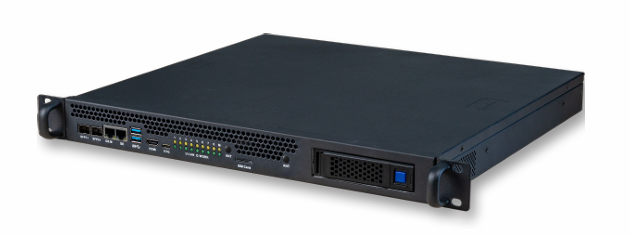
Это уже не просто сервер с ИИ-ускорителем, а распределённая вычислительная платформа в стандартном 1U-исполнении, объединяющая 8 вычислительных узлов и управляющий узел в одном шасси. Такой подход позволяет получить преимущества кластерной архитектуры – масштабируемость, параллельную обработку задач и высокую плотность вычислений – в компактном серверном форм-факторе.
Сервер обеспечивает до 256 TOPS вычислительной производительности и ориентирован не только на классические задачи инференса, но и на приватное развёртывание современных больших моделей. Платформа поддерживает локальный запуск популярных LLM семейства Transformer, визуальных моделей и генеративного ИИ, что делает её применимой не только для видеоаналитики, но и для построения корпоративных ИИ-сервисов в защищённом контуре.
Ключевые особенности платформы CSA1-N8:
- до 256 TOPS ИИ-производительности;
- 8 распределённых вычислительных узлов в 1U-сервере;
- до 256 каналов ИИ-видеообработки;
- поддержка LLM, VLM и генеративных моделей;
- поддержка TensorFlow, PyTorch, ONNX, PaddlePaddle и других фреймворков;
- 2 × 10GbE SFP+, Gigabit Ethernet и встроенная BMC-система управления;
- возможность локального хранения данных через SATA SSD/HDD;
- высокая плотность вычислений при умеренном энергопотреблении.
Такие серверы могут использоваться в системах интеллектуального видеонаблюдения, промышленных ИИ-шлюзах, проектах «умного города», а также в пилотных внедрениях частного ИИ, где заказчику требуется собственная инфраструктура без развёртывания тяжёлого GPU-кластера.
Универсальные многоузловые ИИ-серверы: баланс производительности и масштабируемости
Для большинства коммерческих ИИ-проектов возможностей начального серверного уровня уже может быть недостаточно, особенно если речь идёт о большом количестве потоков видеоаналитики, приватном запуске LLM, распределённом инференсе или корпоративных ИИ-сервисах, работающих круглосуточно. В этом сегменте Firefly предлагает универсальные многоузловые ИИ-серверы CSB1-N10 и CSB2-N10, которые можно рассматривать как следующий уровень развития распределённой ИИ-инфраструктуры.
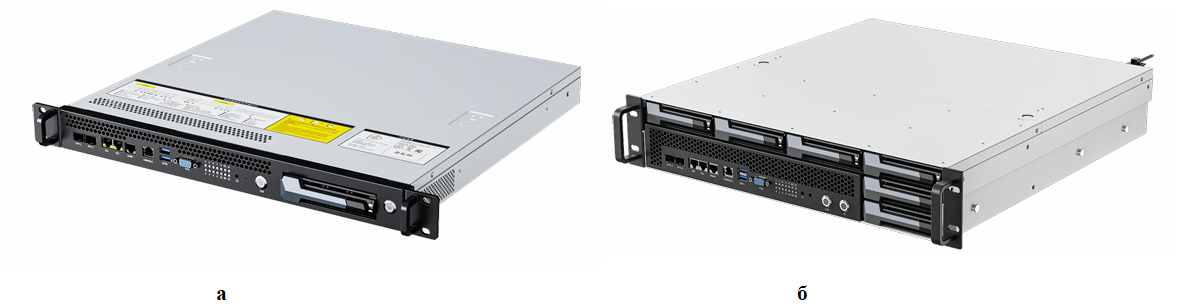
Эти системы объединяют 10 вычислительных узлов и управляющий узел в одном сервере и строятся по модульной архитектуре, поддерживая различные вычислительные платформы – от Rockchip и SOPHON до NVIDIA Jetson Orin NX. Такой подход позволяет подбирать конфигурацию не под абстрактную «мощность», а под конкретную нагрузку: от энергоэффективного инференса до высокопроизводительных ИИ-сервисов и частного развёртывания больших моделей.
В зависимости от конфигурации производительность таких серверов достигает 1570 TOPS, что уже выводит их в класс серьёзных серверных решений. При этом это не просто вычислительная мощность ради мощности: архитектура ориентирована на параллельное выполнение множества задач, обслуживание распределённых ИИ-сервисов и построение частной ИИ-инфраструктуры.
Ключевые особенности платформ:
- 60 TOPS, 320 TOPS и 1570 TOPS ИИ-производительности в зависимости от конфигурации;
- 10 распределённых вычислительных узлов в одном сервере;
- поддержка NVIDIA Jetson, SOPHON, Rockchip и других платформ;
- до 196 каналов ИИ-видеообработки;
- поддержка LLM, VLM и генеративных моделей;
- поддержка TensorFlow, PyTorch, ONNX, Docker (платформа контейнеризации), Ollama и других инструментов;
- 2 × 10GbE SFP+, Gigabit Ethernet, встроенный BMC;
- поддержка локального хранения и масштабируемого хранилища.
Особенно важно, что это уже не просто ИИ-серверы для инференса, а фактически универсальные платформы для построения распределённых ИИ-сервисов. Они подходят как для компьютерного зрения и видеоаналитики, так и для локальных корпоративных LLM, генеративного ИИ и мультисервисных ИИ-нагрузок. Отдельного внимания заслуживает CSB2-N10, который развивает эту концепцию дальше. В отличие от более компактного 1U-сервера CSB1-N10, это уже 2U-сервер с расширенными возможностями хранения, PCIe-расширением и опциональным резервированием питания. По сути, это переход от сервера для периферийных вычислений к компактному ИИ-серверу уровня мини-датацентра.
Такие платформы могут применяться в интеллектуальном видеонаблюдении, корпоративных инференс-сервисах, локальном развёртывании LLM, промышленной автоматизации, телекоме и распределённых ИИ-шлюзах, а также в ИИ-платформах, работающих как сервис внутри предприятия. Если CSA1-N8 можно рассматривать как вход в распределённую ИИ-инфраструктуру, то CSB1-N10 и CSB2-N10 – это уже её производственный уровень, где важны масштабирование, отказоустойчивость и способность обслуживать реальные коммерческие нагрузки без перехода к тяжёлым GPU-кластерам.
Высокопроизводительные серверы для больших моделей и генеративного ИИ
Для задач, где требуется не просто масштабируемый инференс, а максимальная вычислительная плотность для работы с большими языковыми моделями, мультимодальным ИИ и генеративными нагрузками, Firefly предлагает сервер CSB1-N4AGXOrin, построенный на базе NVIDIA Jetson AGX Orin.
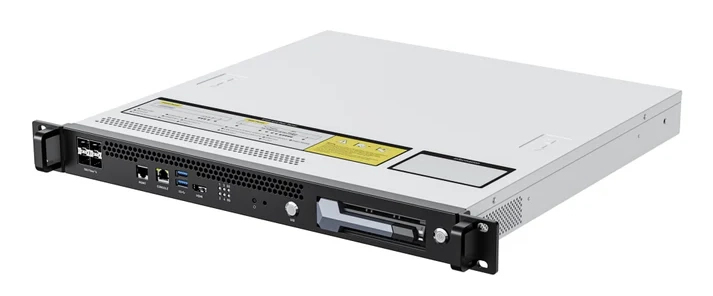
Это уже не просто многоузловой ИИ-сервер, а фактически компактный edge-суперкомпьютер, то есть компактный периферийный суперкомпьютер, в стандартном 1U-форм-факторе. Платформа объединяет 4 вычислительных узла Jetson AGX Orin и управляющий узел, обеспечивая до 1100 TOPS вычислительной производительности, что выводит её в класс решений для тяжёлых ИИ-нагрузок. В отличие от универсальных ИИ-серверов, ориентированных прежде всего на распределённый инференс, CSB1-N4AGXOrin создавался именно для сценариев, где необходимы ресурсоёмкие модели и высокая плотность вычислений в компактной серверной системе. Это включает локальное развёртывание больших языковых моделей, генеративный ИИ, мультимодальный инференс, сложные модели компьютерного зрения и робототехнические приложения.
Ключевые особенности платформы:
- до 1100 TOPS ИИ-производительности;
- 4 вычислительных узла NVIDIA Jetson AGX Orin;
- поддержка приватного развёртывания LLM и мультимодальных моделей;
- поддержка генеративных моделей: Flux, Stable Diffusion, SDXL;
- фреймворки PyTorch, TensorFlow, cuDNN, Ollama, ComfyUI;
- 4 × 10GbE SFP+ для высокоскоростного обмена данными;
- поддержка 8K-декодирования и 4K-видеообработки;
- встроенная BMC-платформа для удалённого управления.
Сильная сторона этого решения – сочетание серверной архитектуры и экосистемы NVIDIA Jetson. Заказчик получает не только высокую ИИ-производительность, но и доступ к зрелому программному стеку NVIDIA для ускорения разработки и развёртывания сложных ИИ-приложений. Такая платформа особенно интересна в сценариях, где обычных серверов для инференса уже недостаточно, а требуются локальные корпоративные LLM и private GPT (частный GPT), интеллектуальные ассистенты и агентные системы, робототехника и автономные платформы, продвинутая видеоаналитика и сложное компьютерное зрение, а также edge-системы, которым нужен серверный уровень вычислений.
Именно такие платформы сегодня всё чаще рассматриваются как основа ИИ-инфраструктуры для генеративного ИИ, особенно там, где облачные ресурсы нежелательны или экономически неэффективны.
Кластерные ИИ-серверы и микро-датацентры для частной ИИ-инфраструктуры
Когда задачам уже недостаточно одного высокопроизводительного ИИ-сервера и требуется масштабируемая инфраструктура для обслуживания больших моделей, распределённого инференса или корпоративных ИИ-сервисов на уровне дата-центра, Firefly предлагает кластерные решения нового класса – CSC2-N48.
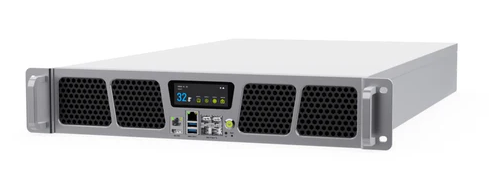
Это уже не просто сервер для ИИ, а фактически компактный ИИ-кластер в 2U-исполнении, который можно рассматривать как микро-датацентр для частного развёртывания ИИ-нагрузок. Платформа объединяет 48 распределённых вычислительных узлов и управляющий узел в одном шасси и, в зависимости от конфигурации, обеспечивает до 7536 TOPS вычислительной производительности. По сути, CSC2-N48 переносит идею распределённых ИИ-нод на уровень серверного кластера высокой плотности. Вместо классической архитектуры тяжёлых GPU-стоек здесь используется масштабирование количеством вычислительных узлов, что даёт высокую плотность TOPS, гибкость конфигурации и энергоэффективность.
Ключевые особенности платформы:
- 288 TOPS, 1536 TOPS или 7536 TOPS вычислительной производительности в зависимости от комплектации;
- 48 вычислительных узлов в одном 2U-сервере;
- поддержка платформ NVIDIA Jetson, SOPHON и Rockchip;
- поддержка LLM, VLM и генеративных моделей;
- до 48 NVMe-накопителей для масштабируемого высокоскоростного хранения;
- 4 × 10GbE SFP+ для кластерных и сетевых нагрузок;
- резервируемое питание и BMC для серверного уровня отказоустойчивости;
- поддержка Docker (платформа контейнеризации), виртуализации, баз данных и распределённых сервисов.
Особенно важно, что CSC2-N48 ориентирован не только на ИИ-инференс в узком смысле, но и на построение полноценной частной ИИ-инфраструктуры. Платформа поддерживает запуск больших языковых моделей, визуальных моделей, генеративного ИИ, а также сопутствующих сервисов – баз данных, аналитических платформ и контейнеризированных приложений, что делает её ближе к ИИ-микро-датацентру, чем к традиционному серверу. Это открывает возможности для сценариев, где требуется уже не отдельный ИИ-узел, а масштабируемая вычислительная среда, например для корпоративных LLM-систем, интеллектуальных платформ «умного города», распределённых ИИ-сервисов в телекоме и промышленности.
Итоги: серверная ИИ-инфраструктура нового поколения
Серверные решения Firefly интересны тем, что предлагают не отдельные устройства под разные задачи, а фактически целостную линейку ИИ-инфраструктуры – от компактных серверов для инференса до кластерных систем уровня микро-датацентра. При этом подход Firefly заметно отличается от классических GPU-серверов: ставка делается не только на абсолютную вычислительную мощность, но и на распределённую архитектуру, высокую плотность TOPS, энергоэффективность и масштабирование.
Все серверы Firefly для ИИ – от компактных платформ для инференса до кластерных систем – доступны в компании «Матрикс Электроника», официального партнёра Firefly. Специалисты компании помогут подобрать решение под ваши задачи с учётом требований к вычислительной мощности, масштабированию, сетевой инфраструктуре и условиям эксплуатации.